AI 프로젝트2026.07 – 진행 중2인 팀
SSAFY 16기 관통 프로젝트 — ThRead: LLM 댓글 분석 파이프라인 · AI 도서 서비스
도서·독서 커뮤니티 서비스 ThRead를 5회에 걸쳐 확장하며, 데이터 수집부터 LLM 분석·웹 서비스까지 직접 구현
문제
SSAFY 관통 프로젝트에서 하나의 서비스(ThRead)를 회차마다 확장 — Python 데이터 처리 → 외부 API → 반응형 웹 → Django 인증 → 크롤링·LLM 파이프라인
역할
2인 팀에서 Django 구조 설계, 백엔드, 생성형 AI·외부 API 연동, 크롤링·데이터 파이프라인을 담당
한 일
- 관통 5 · 댓글 분석 파이프라인: Selenium으로 토스증권 커뮤니티 댓글 20개를 실시간 수집 → LLM이 부적절 댓글 번호만 판단하고 코드가 원본에서 제거 → pandas·정규식 정제 → IQR로 길이 이상치 기준 계산 → LLM 증강(개수 불일치 시 재시도) → 요약까지 단계별로 DB 저장
- 관통 5: 30초 이상 걸리는 작업의 진행 상황을 StreamingHttpResponse(NDJSON)+스레드·큐로 실시간 표시, 회사 없음·댓글 없음·LLM 실패 등 예외 상황을 구분해 안내
- 관통 4 · AI 도서 서비스: Django 커스텀 User·인증(오픈 리다이렉트 방어, HTTP Method 제한), 도서 CRUD, 위키피디아+LLM 작가 정보 생성, AI 도서 분석, 등록 도서 안에서만 추천하도록 검증한 AI 맞춤 추천, 알라딘 API 수집 명령
- 관통 4: Django TestCase와 mock으로 외부 API 없이 요구사항별 동작을 검증하는 자동 테스트 45개 작성
- 관통 1~3: JSON 도서 데이터 집계·정렬, 알라딘 API 수집(페이지네이션·중복 제거)+LLM 분류+gTTS 음성 변환, Bootstrap 반응형 웹페이지
- SSAFY 16기 AI 챌린지 (2026.09, 이미지+질문 4지선다 VQA, 팀 B022, 모델 학습·정제 담당): Qwen 27B/4B QLoRA·Gemma 31B 파인튜닝·OCR·멀티뷰(해상도·crop) 확률 앙상블로 Public Score 0.96961, GPU 없이 제출을 그대로 재현하는 스크립트(SHA-256 검증)까지 정리
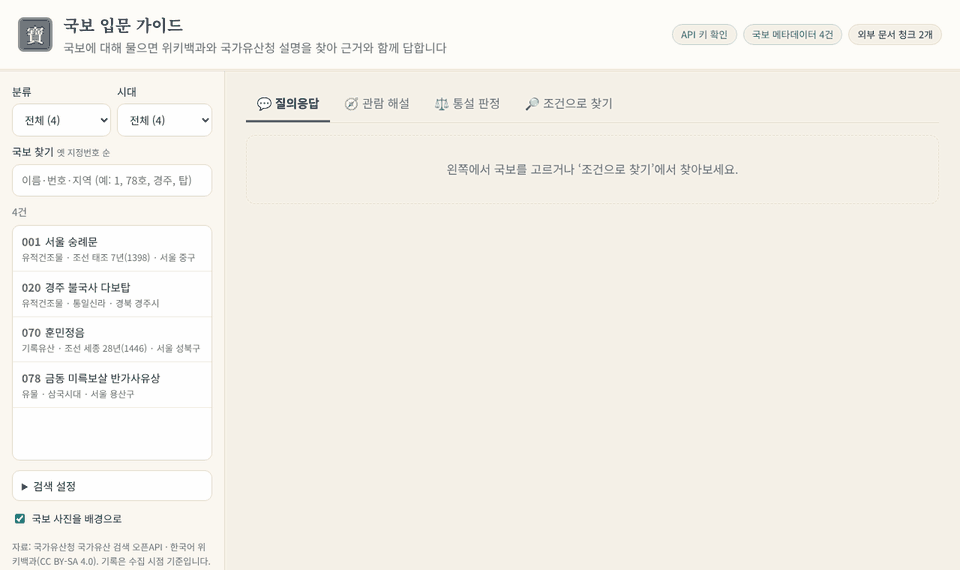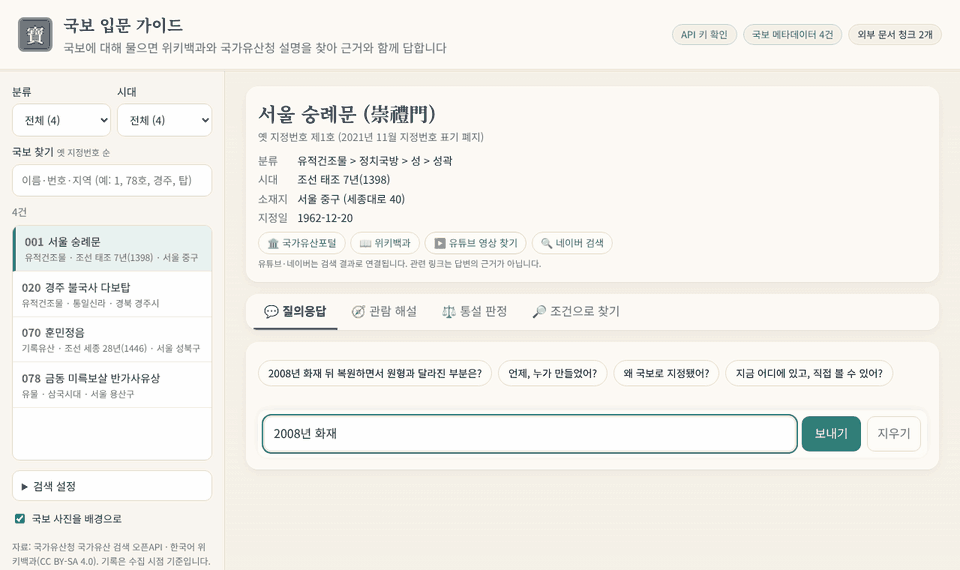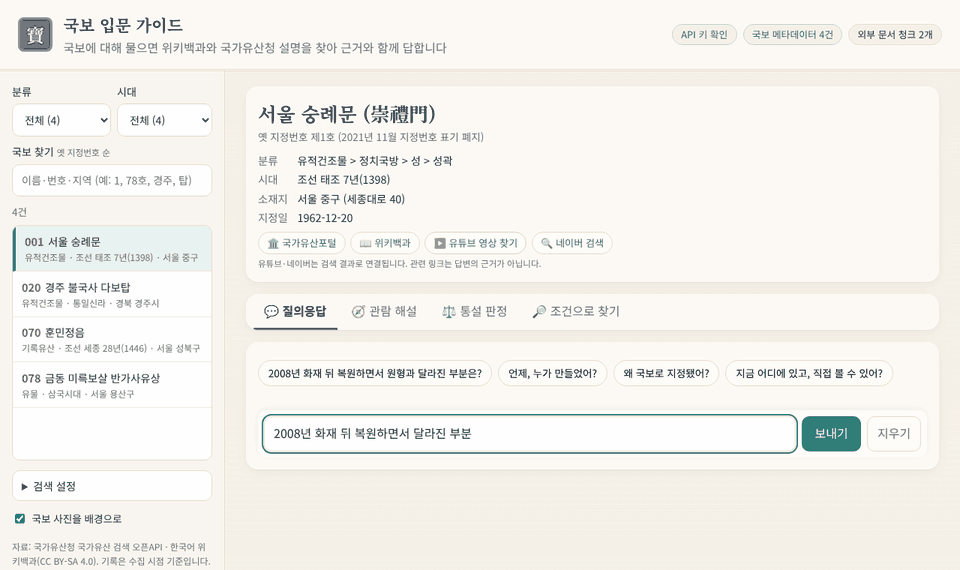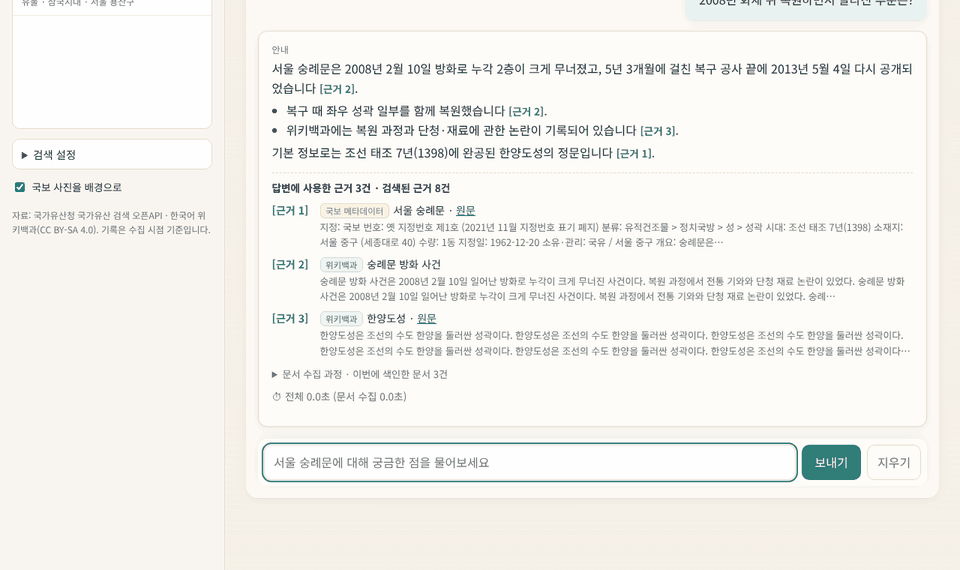
- AI 코어 프로젝트 2 · 국보 입문 가이드 (2026.10, 개인): 국가유산청 오픈API(XML·EUC-KR)로 국보 목록·상세·공식 설명을 수집하고 국보명을 위키백과 문서에 자동 연결(일반명사 문서 오연결 방지) → ChromaDB 2개 컬렉션(국보 1건=청크 1개 / 위키·공식 설명 청크, ID 고정으로 재실행해도 중복 없음) → 질문마다 LLM이 검색어 추출·문서 선별 후 수집·색인(캐시·위키 장애 시 저장본 대체) → LangGraph retrieve→generate, 답변의 [근거 N]을 코드로 검사해 없는 번호 제거. 관람 해설·통설 판정·조건 탐색 기능, Streamlit+FastAPI 화면, 가짜 LLM·AppTest 기반 테스트 50개
- 새내기 캠프 3인 팀 프로젝트 「요기유(YOGIU)」 — 대전·충청 AI 여행 커뮤니티 웹 서비스, 개발·발표 담당: 카카오맵 API 기반 동선 플래너(찜·지도), OpenAI API 기반 AI 추천 여행 경로·꿈돌이 테마 챗봇, 테마별 관광 정보·축제·익명 게시판(댓글) 구현
- SSAFY AI 과정: Perceptron 구현, Transformer·BERT, RAG 검색, 프롬프트 엔지니어링, CNN·ViT / 일타싸피(삼각함수 기반 당구 AI), 배틀싸피 자동 플레이 봇(매 턴 재계획 BFS·탄약 판단·보급 암호 해독), SWEA 알고리즘
결과
- LLM 응답을 그대로 믿지 않고 코드로 검증하는 구조(번호 범위 검사, 뒤에서부터 제거, 등록 도서 id만 허용)로 안정적인 AI 기능 구현
- 자동 테스트 관통 4 45개 · 관통 5 41개 통과, 관통 5 요구사항(F601~F611) 전부 구현 + 진행 상황 스트리밍·분석 이력·11가지 화면 테마 추가
설계 판단 · 트레이드오프
무엇을 고르고, 그 대신 무엇을 포기했는지
ThRead: LLM에는 '어떤 댓글이 부적절한가' 같은 판단(번호)만 맡기고, 삭제·채택은 코드가 원본에서 처리 — LLM이 직접 고쳐 쓰는 방식보다 유연성은 줄지만 원본 보존과 개수 보장을 얻음
국보 가이드: 근거 번호를 검색 단계에서 고정하고 LLM은 가리키기만 하게 함 — 답변 표현의 자유는 줄지만 인용 검증이 단순한 집합 비교가 됨
VQA 챌린지: 새 후보를 정확도 대신 고친 문제와 새로 틀린 문제(fixes−breaks)·유형별 회귀로 채택 — 점수 상승 폭만 보는 것보다 느리지만 '믿을 수 있게 오른' 제출만 남김
테스트: 외부 API 대신 mock·가짜 LLM으로 결정적인 테스트를 만듦 — 빠르고 매번 같은 결과가 나오는 대신, 실제 모델의 답변 품질은 측정하지 않음
돌아보면 · 남은 과제
다시 한다면 바꿀 것, 아직 남은 것
가짜 LLM 테스트는 규칙(인용 검증·예외 처리)을 보장하지만 답변 품질 자체는 재지 못함 — 실제 모델로 질문 세트를 만들어 검색 적중·인용 정확도를 평가하는 것이 다음 단계
배운 것: 실패했을 때의 기본값(JSON이 깨지면, 선별이 실패하면, 인용이 없으면)을 먼저 정해 두니 LLM 응답이 흔들려도 서비스는 안정적으로 동작함
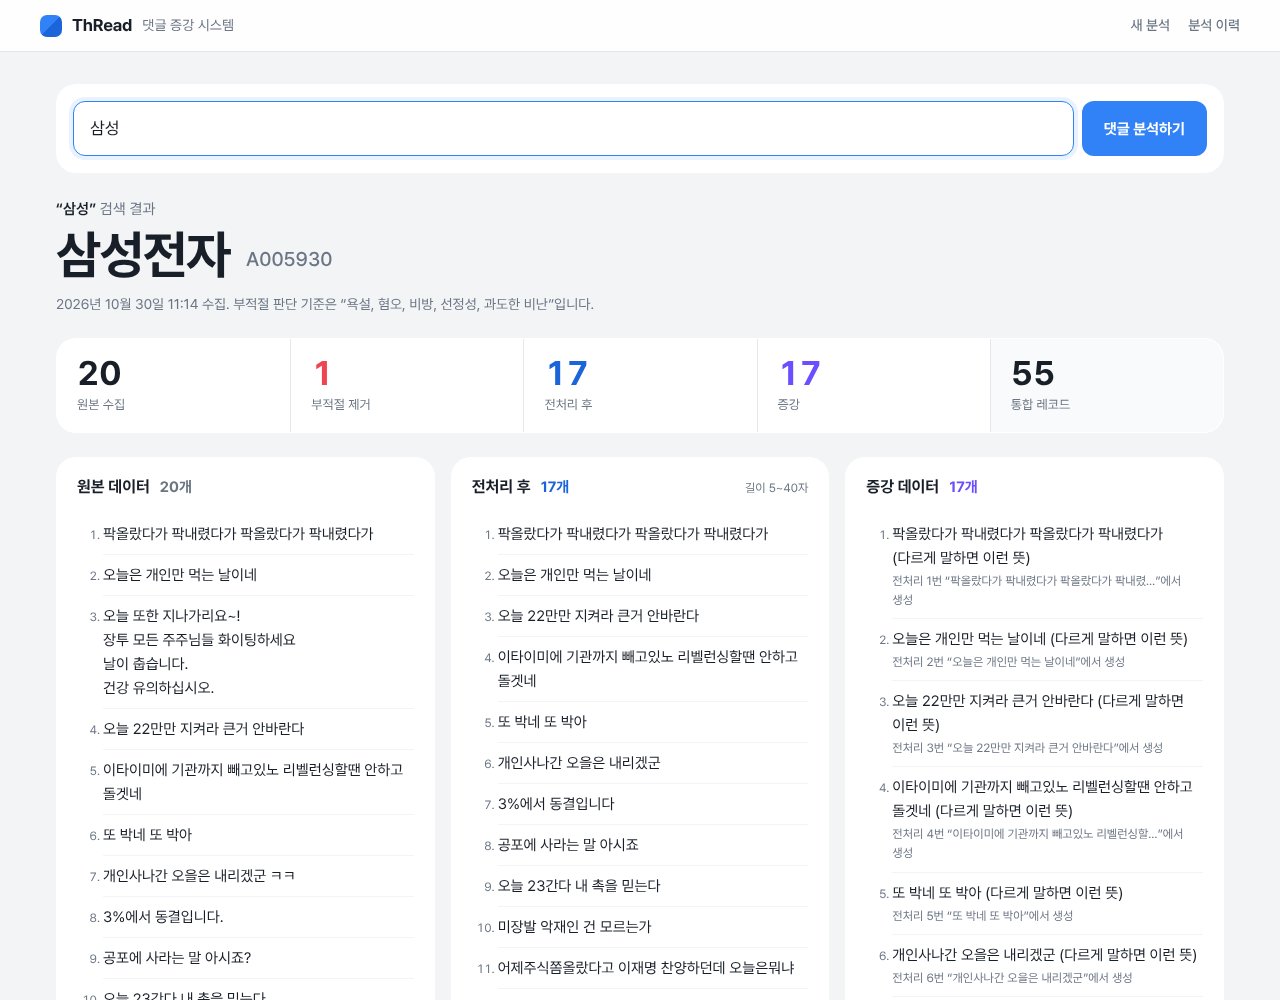 관통5 LLM 댓글분석 결과화면
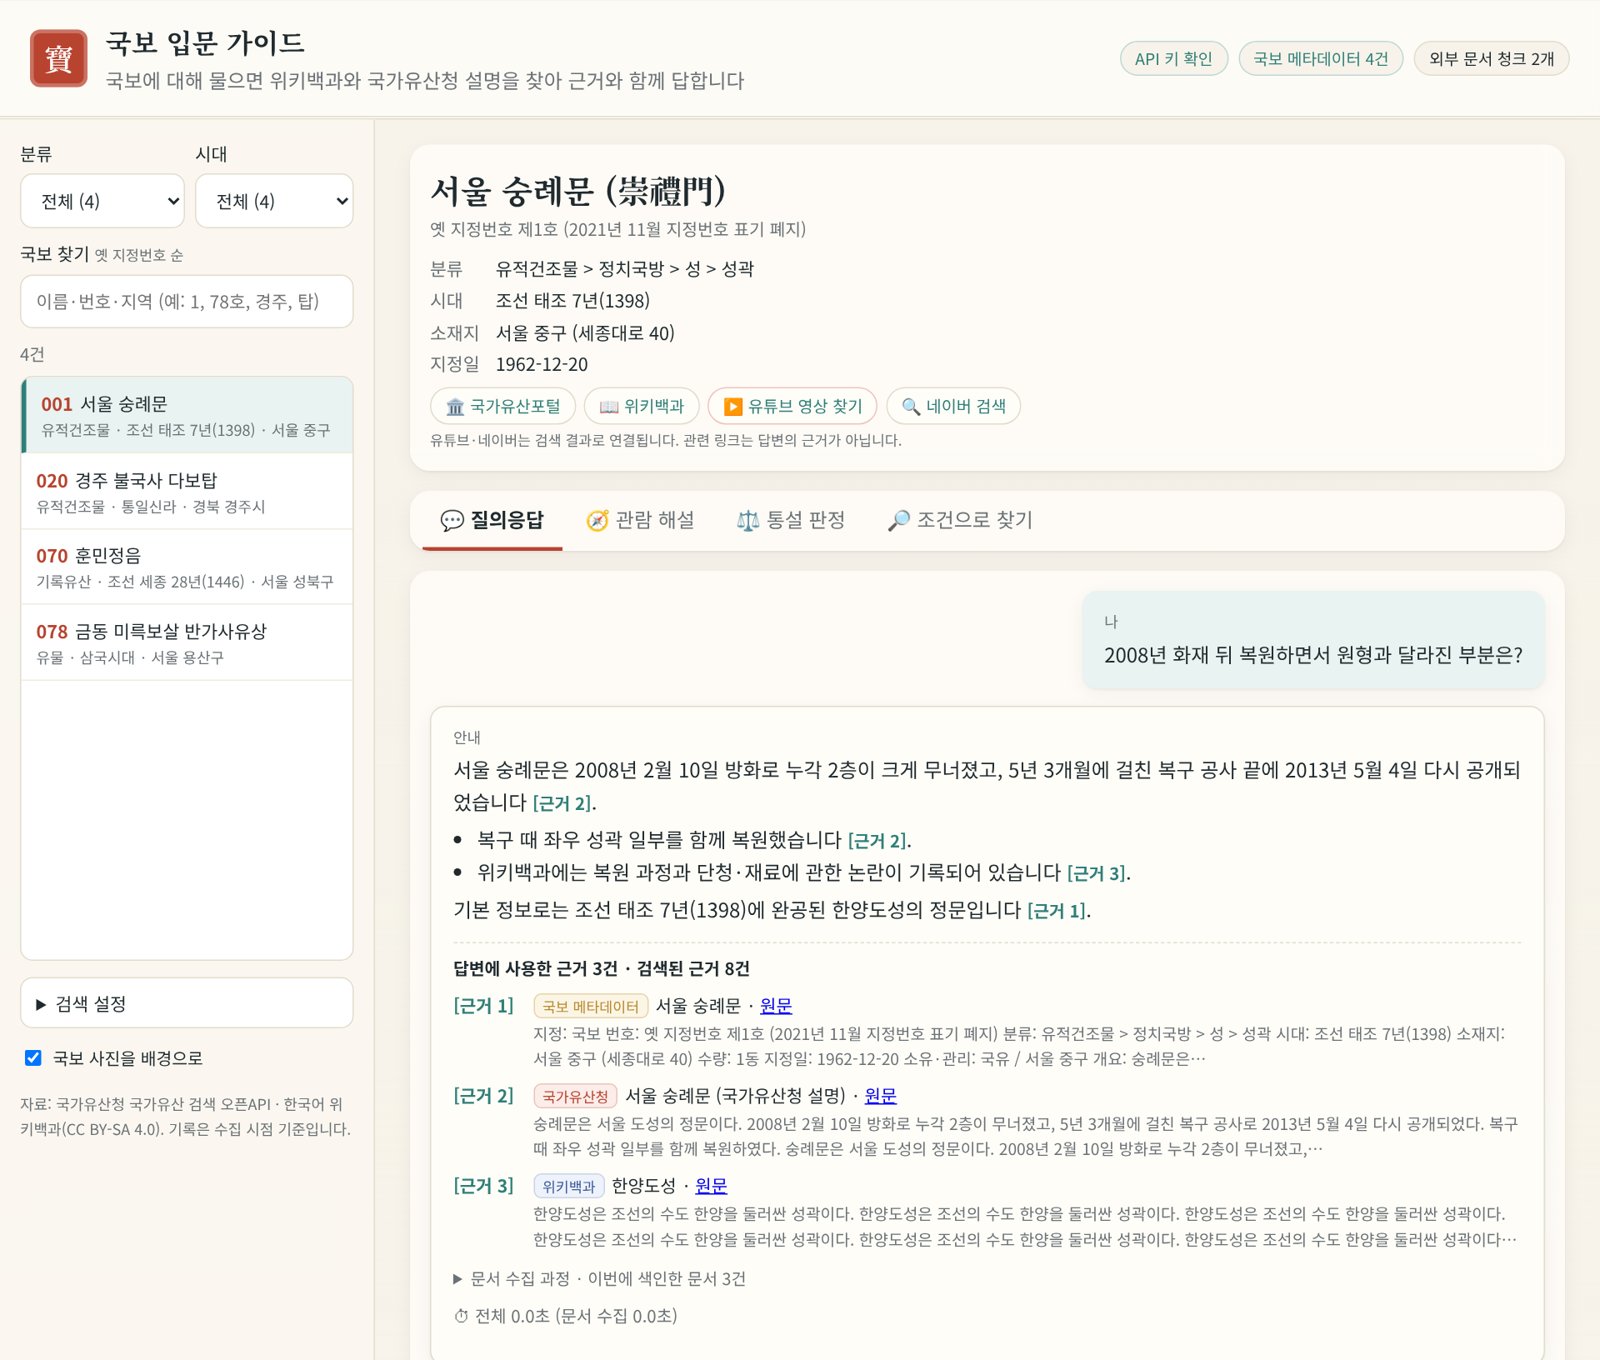 국보입문가이드 RAG 질의응답 화면