AI 프로젝트2025.06 – 2025.08팀 프로젝트 · 장려상
POSPEAK(KILL KONG) — 콩글리시 → 원어민 표현 교정 AI (FLAN-T5·Qwen + RAG)
어색한 영어·콩글리시 문장을 자연스러운 원어민 표현으로 바꿔 주는 생성 모델 + 검색 증강(RAG) 시스템
문제
한국 학습자가 쓰는 콩글리시와 어색한 격식체 영어는 문법 교정기로 잡히지 않아, 문맥에 맞는 자연스러운 표현으로 바꿔 주는 도구가 필요했음
역할
팀에서 교정 학습 데이터 구축과 모델 실험을 맡아, 단어 단위·문맥 단위 교정 데이터로 T5 계열 모델의 학습 전략을 찾는 것이 목표
한 일
- [담당] 콩글리시·어색한 표현 → 원어민 표현 쌍으로 이루어진 단어 단위·문맥 단위 교정 데이터셋 구축 및 정제
- [담당] FLAN-T5를 LoRA로 파인튜닝하고, 학습 전략 3가지(단어→문맥 순차, 문맥→단어 순차, 통합 학습)를 BERTScore로 비교 실험
- [최종 서비스 'KILL KONG' — POSPEAK의 최종 버전] Qwen-2.5(1.5B) 파인튜닝(Friends 대사 기반 회화체 데이터 2,000건) + 콩글리시 RAG DB 630건 + 사용자별 개인화 메모리(오답노트)를 LangChain으로 결합, React Native·FastAPI 모바일 앱으로 구현
- [팀] 다국어 문장 임베딩(paraphrase-multilingual-MiniLM)과 FAISS로 유사 교정 예문 top-5를 검색해 모델 입력에 제공하는 RAG 파이프라인과 CLI 구성
결과
- 순차 학습에서 앞 단계 성능이 떨어지는 catastrophic forgetting(BERTScore F1 0.47 → 0.32)을 실험으로 확인하고 통합 학습으로 전환
- 통합 학습 모델의 검증 BERTScore F1 약 0.74 (순차 학습 0.32~0.47 대비 개선)
- 팀 프로젝트 장려상 수상
설계 판단 · 트레이드오프
무엇을 고르고, 그 대신 무엇을 포기했는지
'쉬운 단어 교정부터 어려운 문맥 교정으로' 순차 학습이 직관적이었지만, 같은 조건에서 3가지 전략을 비교해 보고 결정 — 실험 비용은 들었지만 catastrophic forgetting을 발견하고 통합 학습으로 전환
각 학습 단계 직후의 성능을 따로 기록 — 마지막 점수만 봤다면 '그냥 성능이 낮다'로 끝났을 원인을 찾을 수 있었음
돌아보면 · 남은 과제
다시 한다면 바꿀 것, 아직 남은 것
순차 학습이 꼭 필요한 상황이라면 이전 데이터를 일부 섞는 replay나 가중치 변화를 제한하는 정규화(EWC 등)를 검토 — 이번에는 데이터가 크지 않아 통합 학습이 가장 단순하고 효과적이었음
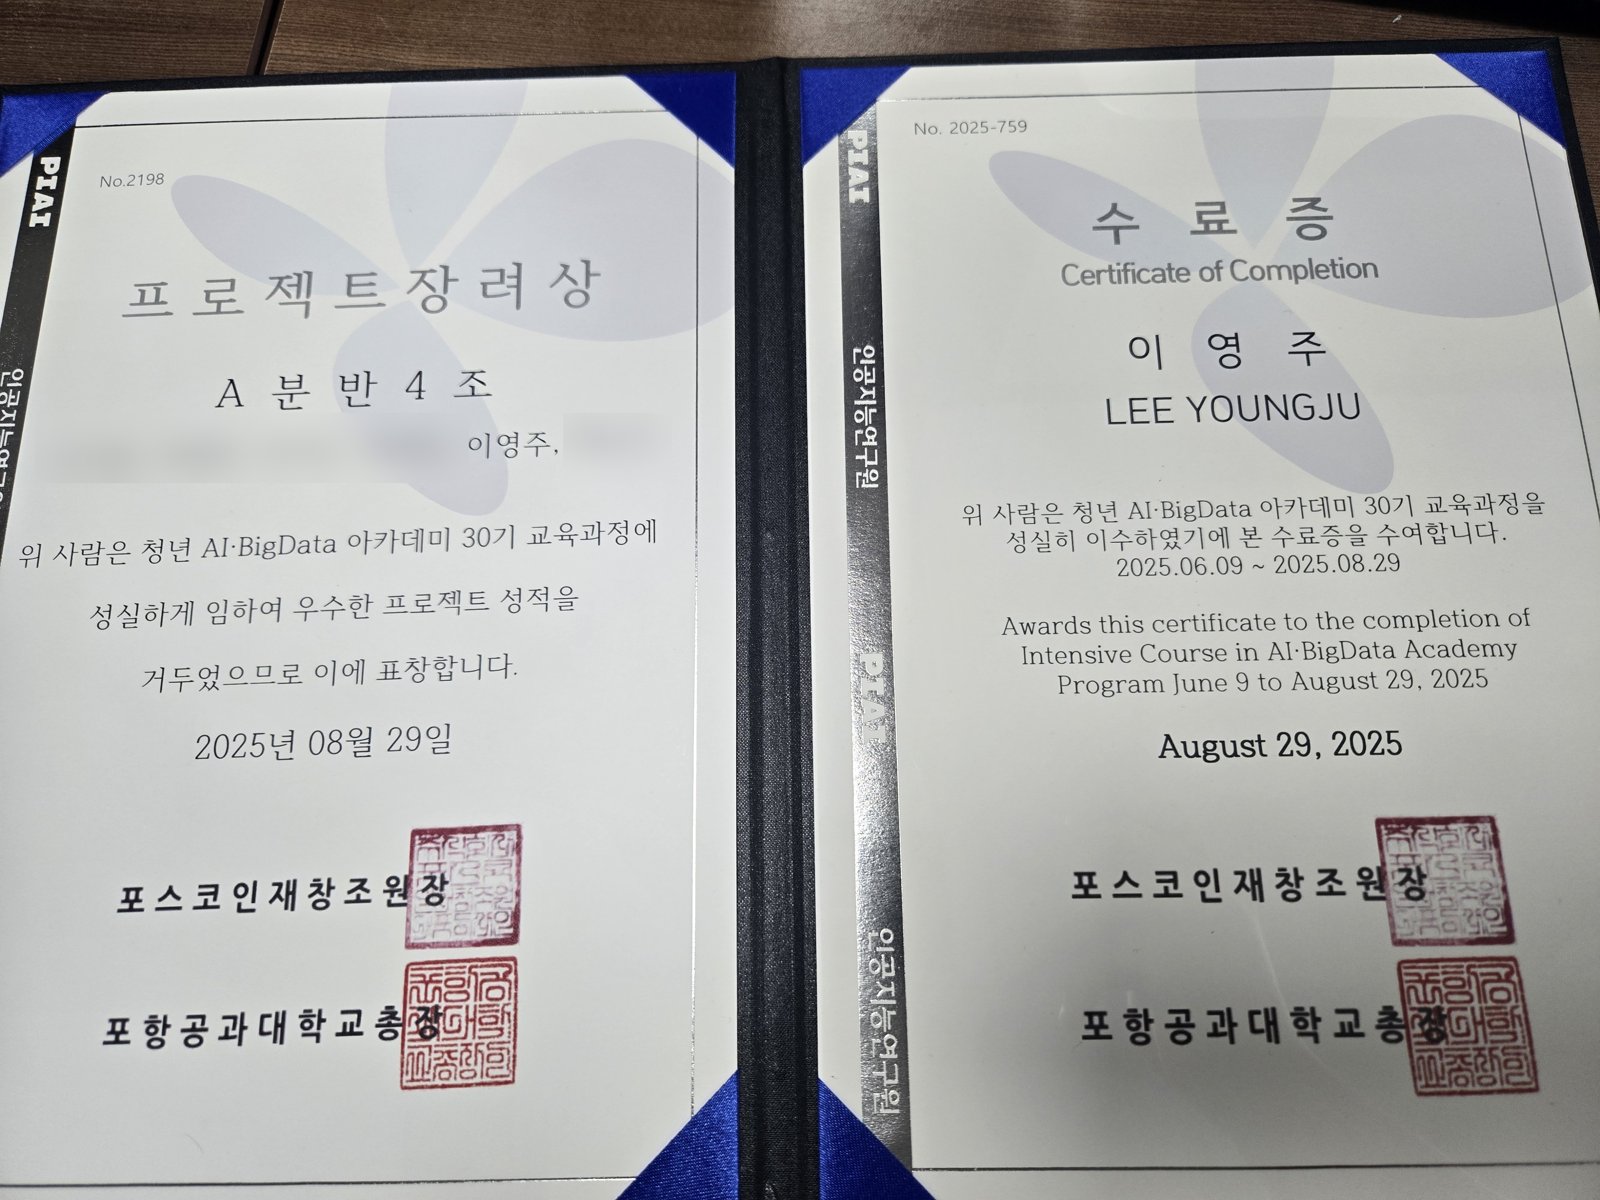 2025-08-29 프로젝트 장려상·수료증